Dressora 使用指南
如何使用 AI 换装工具
从准备人物照片、选择内置造型或上传服装,到检查并改进生成结果的完整入门流程。
快速答案
从一张清晰的人物照片开始,选择内置的 Dressora 外观或上传服装图像,然后生成并检查结果。清晰的输入和可见的身体形状比长提示更重要。
准备一张清晰的人物照片
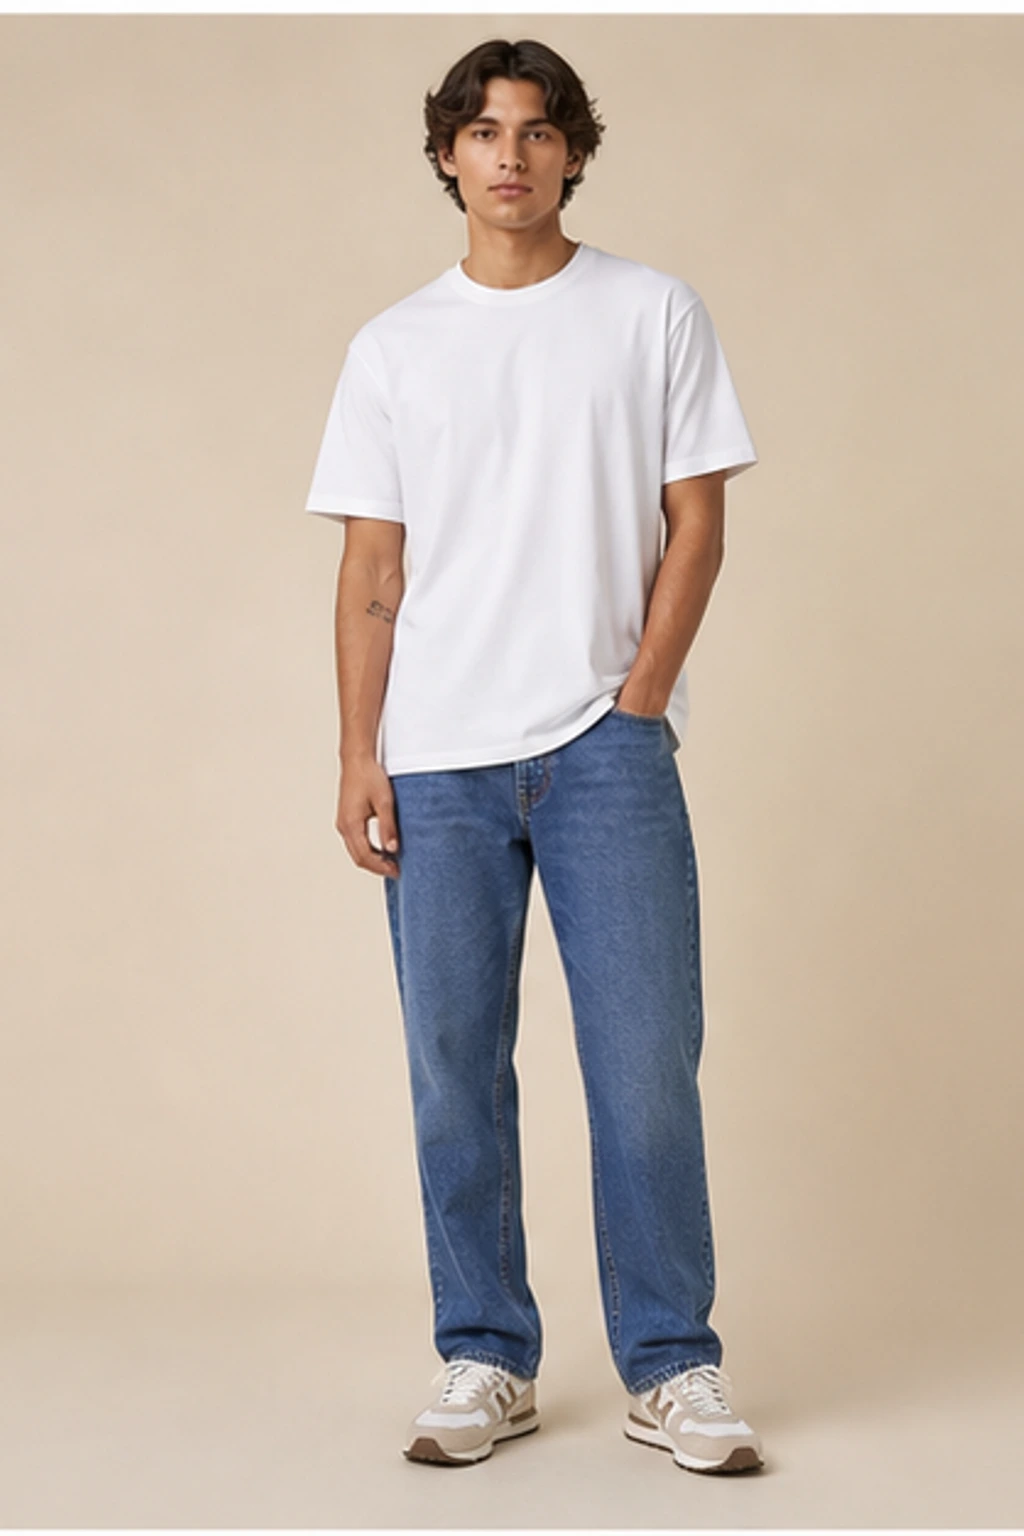
选择光线均匀的清晰人像或全身照片。保持脸部可见,并在身体周围留出一些空间。简单的背景和轻松的正面姿势为模型提供了更清晰的视觉信息。
- 在框架中使用一个人
- 避免严重模糊、滤镜和深阴影
- 尽可能让手远离重要的衣服边缘
选择您想要如何改变服装
打开 Dressora,然后从 AI 衣橱中选择现成的造型或上传您自己的服装参考。干净的产品照片或清晰可见的服装通常比包含多个项目的小屏幕截图效果更好。
生成、检查和完善
生成后,检查脸部、手部、领口、服装边缘、图案和背景。如果某个区域变化太大,请改进相关输入,而不是添加很长的提示。首先尝试更清晰的人物照片或更干净的服装参考。
决定什么必须保持不变
在生成之前,识别源照片中的不变量:人的身份、姿势、头发、相机角度和背景。服装是有意的改变。这种区别可以帮助您一致地判断结果,而不是接受看起来不再像同一个人的有吸引力的图像。
- 身份:脸型、表情、肤色和头发
- 构图:裁剪、相机角度和身体位置
- 环境:背景物体、照明方向和阴影
编写一条可选指令,添加一个有用的约束
图像应该包含大部分请求。仅当解决真正的歧义时才添加简短说明 - 例如,保持西装外套打开,保留裙子长度或使用干净的电子商务饰面。避免在一代人的时间内堆积对新姿势、新房间、戏剧性灯光、身体重塑和服装更换等不相关的请求。
将结果与可重复的审核进行比较
放大而不是仅判断缩略图。首先检查身份,然后是解剖结构,然后是服装保真度,最后是整体抛光。仅当结果可用于其预期目的时才保存结果。社会观念可以容忍细微的结构差异;面向产品的图像需要更严格的验证。
上传前保护隐私
使用您拥有或有权编辑的照片。检查背景中是否有地址、学校或工作场所徽章、屏幕、文档以及其他不需要出现在图像中的个人信息。对于儿童或客户照片,请获得适当的同意,并在不确定谁有权使用材料时避免上传材料。
组织版本,以便比较仍然有用
将原始人物照片、服装参考和所选结果放在一起。按装备或用途命名导出,而不是下载一个包含无法区分的文件的文件夹。当测试多套服装时,重复使用相同的源肖像并记下哪个输入产生了每个结果;这将实验变成了可重复的工作流程,而不是猜测。
生成前清单
- 一个清晰可见的人
- 脸部和目标衣服区域很锐利
- 姿势不隐藏躯干或腰部
- 一件主导服装或协调的服装
- 没有重要的项目被裁剪掉
- 可选指令仅更改一个额外细节
当第一个结果很弱时要调整什么
| 可见问题 | 最有可能的输入问题 | 最佳下一步行动 |
|---|---|---|
| 这个人看起来不再一样了 | 脸部较小、模糊、经过滤镜处理或阴影强烈 | 使用光线均匀的更清晰的源肖像 |
| 服装与参考不同 | 衣服太小、折叠、分层或阻塞 | 裁剪成一件清晰的服装,完整的轮廓可见 |
| 双手融入袖子 | 手臂或手与衣服边界重叠 | 选择双臂稍微分开的姿势 |
| 整个场景都变了 | 该指令要求进行太多更改 | 删除造型请求并仅重新生成服装变更 |
常见问题
我需要编辑技能吗?
不会。基本工作流程是选择或上传服装、上传人物照片,然后在浏览器中生成结果。
人工智能换衣器是否也可以预测合身和尺码?
不会。它会创建视觉样式预览;它不能取代服装尺寸、尺码表或实物试穿。
我应该在提示中描述每件服装的细节吗?
通常不会。清晰的服装图像比长篇描述更能传达形状和颜色。仅对图像模糊的细节使用文本。
我应该再生多少次?
首先改进不明确的输入。重复相同的弱输入可能会产生不同的工件,而不会使过程更加可靠。
我可以使用集体照吗?
单人图像更安全。对于一群人来说,模特可能不知道哪个人应该收到这套服装。
准备试一套造型?
选择服装,上传一张清晰照片,即可生成自己的 Dressora 虚拟试穿效果。